模型与多模态委托配置指南
Piwin 提供了非常强大且细粒度的模型管理体系。通过灵活的模型配置,你可以将不同特性(深度推理、极速看图、绘图、视频生成)的模型按需组合,让智能体在保证开发质量的同时大幅缩减 Token 开销与响应耗时。
本文档将详细说明推理模型、视觉委托、输出委托、生图模型及视频生成模型的配置方法。
1. 模型配置面板概览
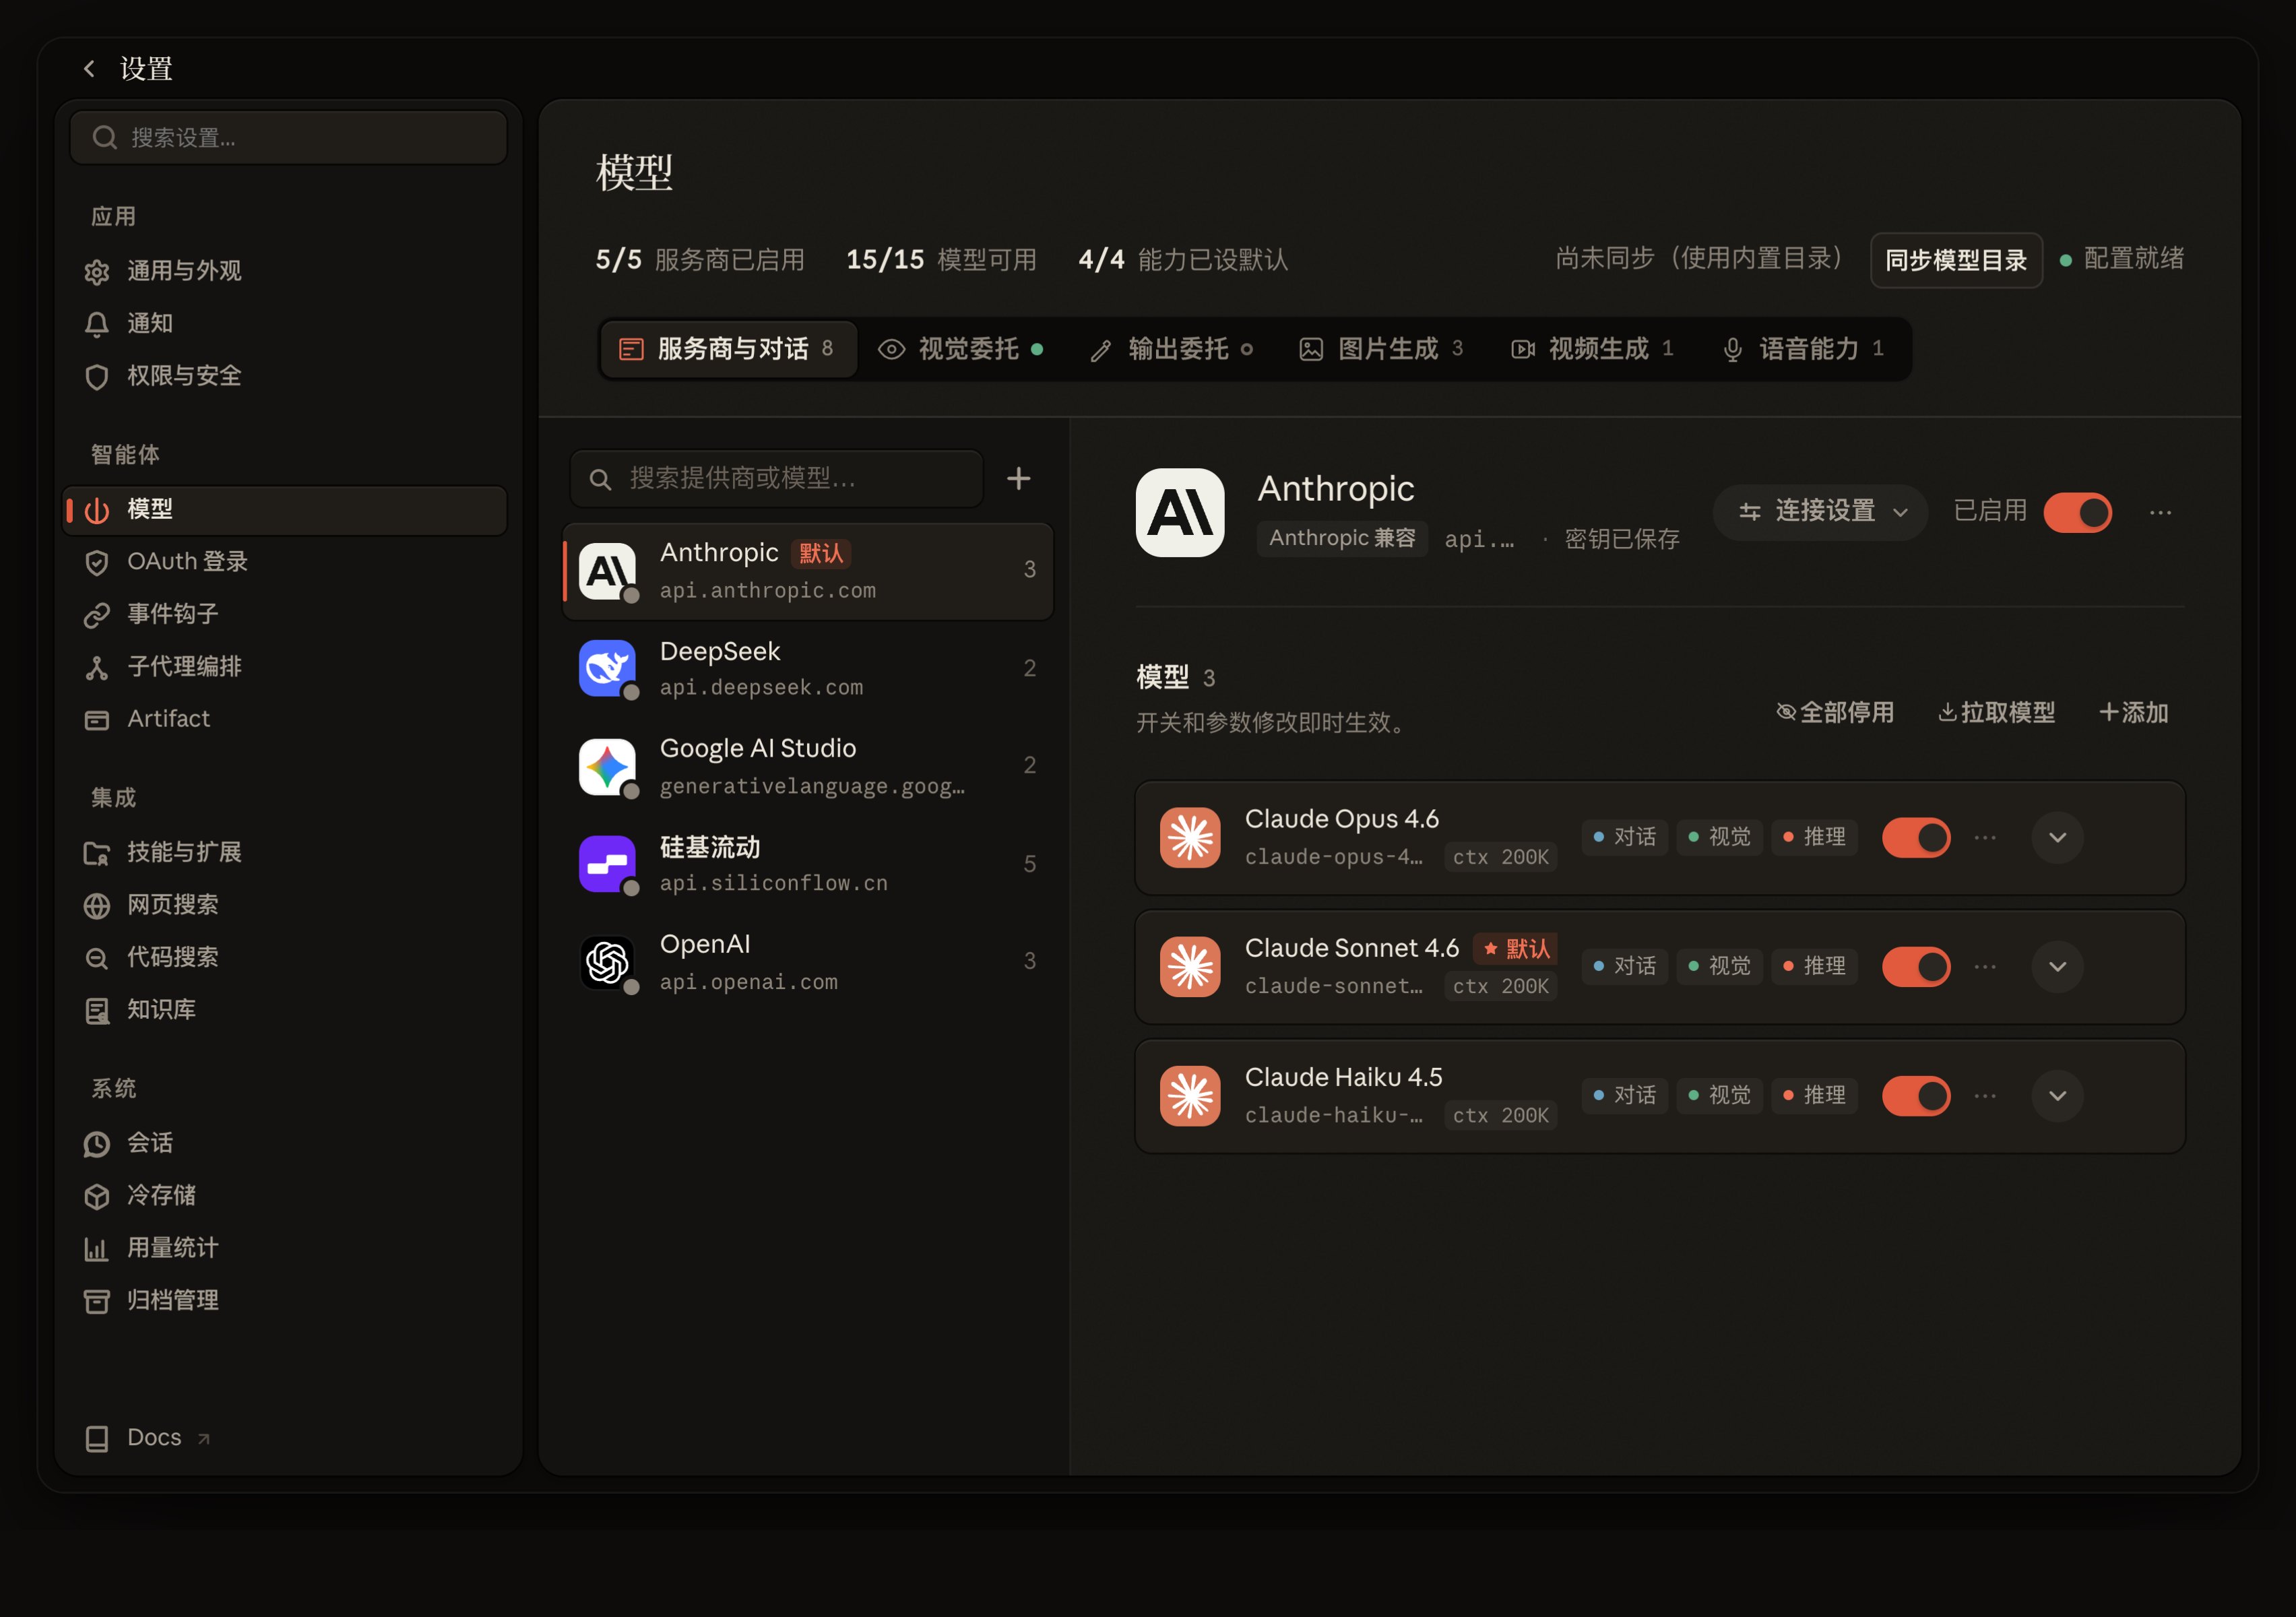
打开客户端 「设置」➔「模型与委托 (Models & Delegation)」,核心配置区域划分如下:
┌─────────────────────────────────────────────────────────────┐
│                    模型与多模态委托配置中心                   │
├─────────────────────────────────────────────────────────────┤
│ 1. 主力推理模型 (Chat Models): DeepSeek V3 / Claude 3.7 / GPT│
│ 2. 视觉委托模型 (Vision Delegate): Gemini 2.5 Flash / Qwen-VL│
│ 3. 输出委托模型 (Output Delegate): [可选] 用于润色结论       │
│ 4. 图像生成模型 (Image Generation): Flux / DALL-E / SD       │
│ 5. 视频生成模型 (Video Generation): Kling / Runway / Luma    │
└─────────────────────────────────────────────────────────────┘
2. 视觉委托模型 (Vision Delegation)
2.1 为什么需要视觉委托?
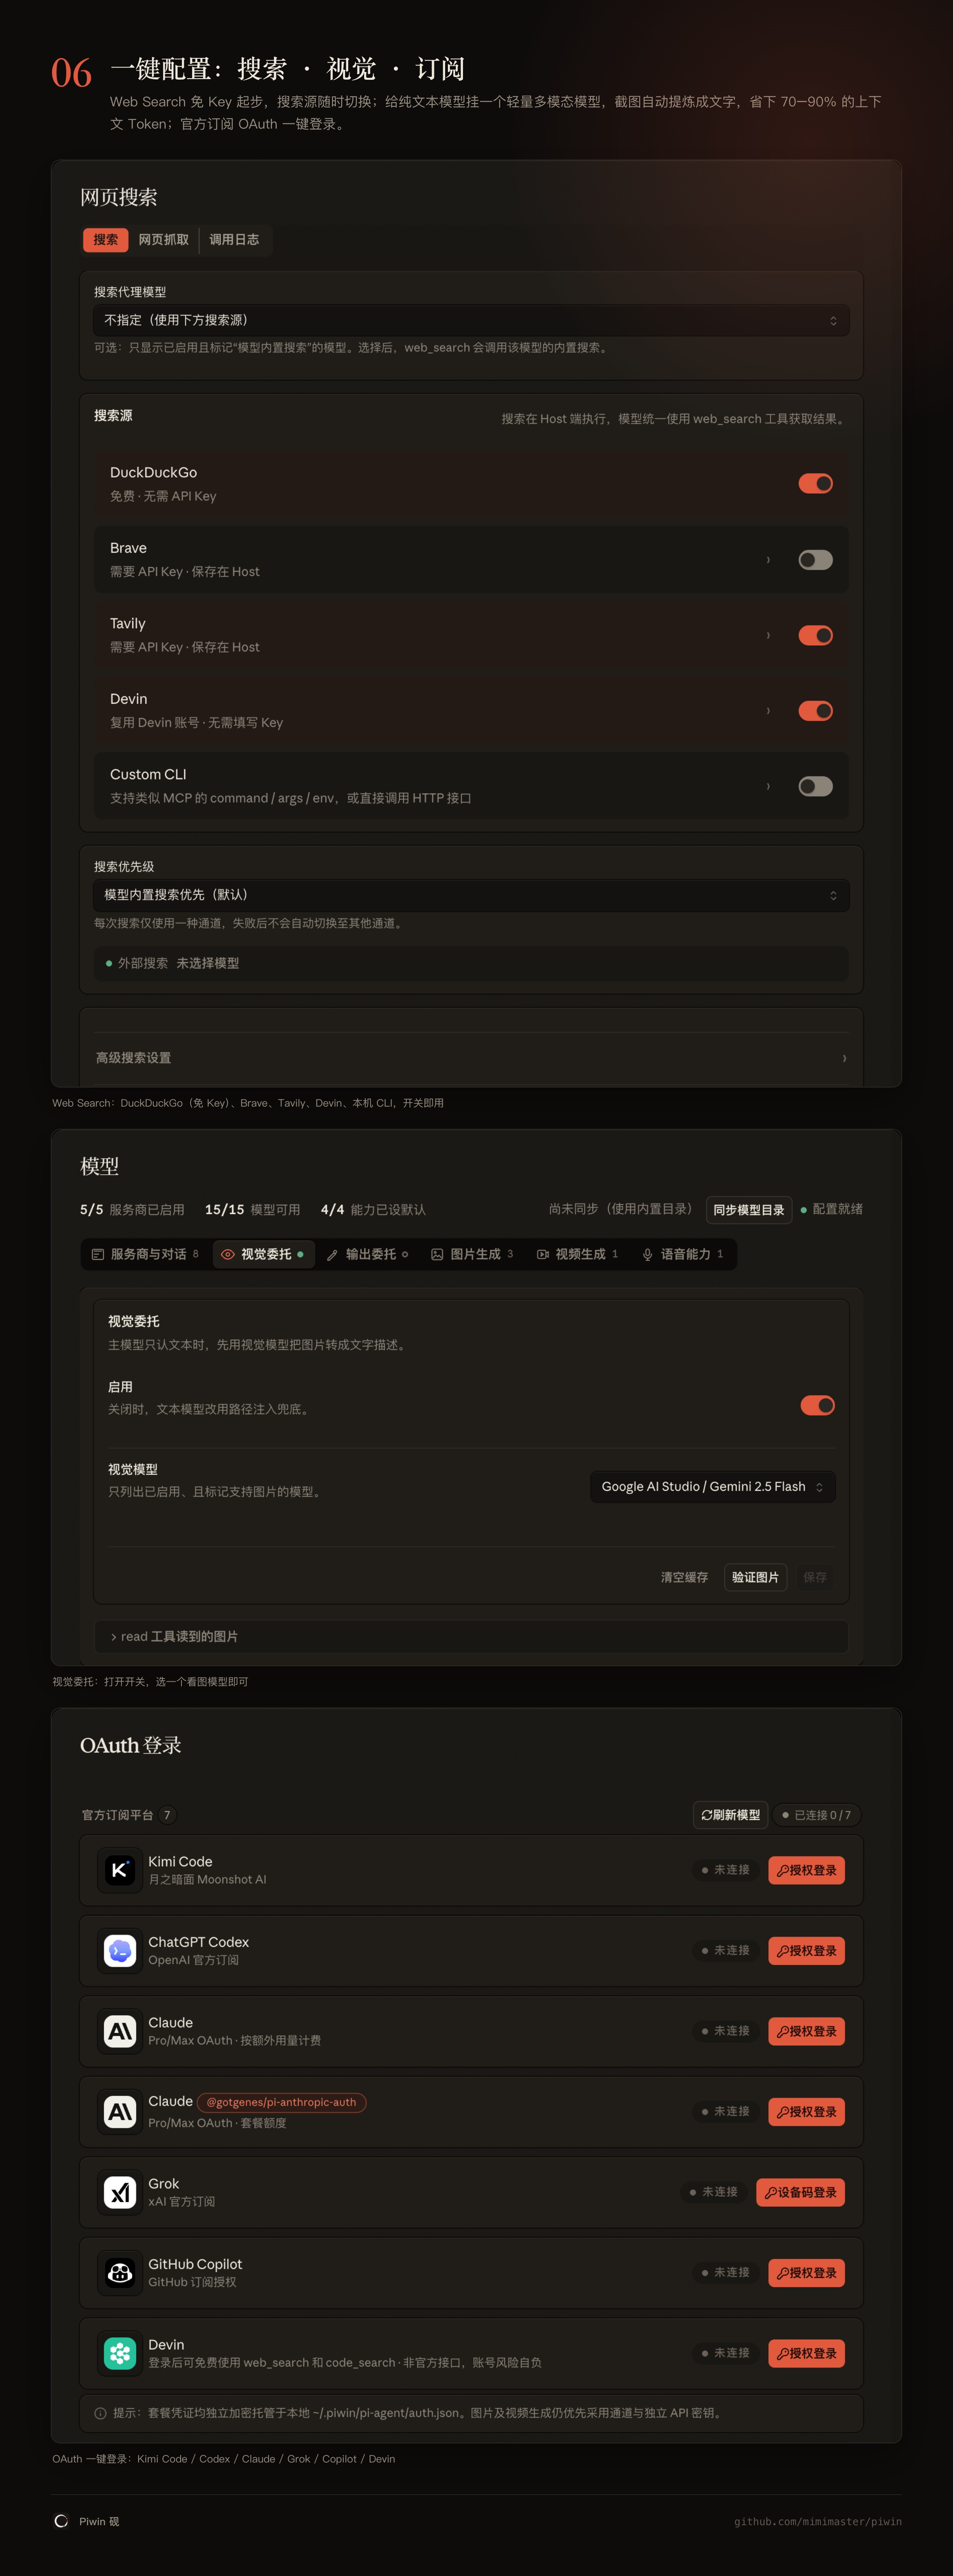
许多顶级的代码推理模型(如某些纯文本模型、或每百万 Token 价格高昂的思考模型)在直接处理大分辨率 UI 截图或系统架构图时,会耗费海量上下文 Token,且推理耗时极长。
视觉委托机制通过运行时 Hook 实现了任务拆解:
- 轻量模型看图:当你粘贴或上传一张图片时,Piwin 自动唤起低延迟、高性价比的轻量多模态模型进行特征提取与 OCR 转录;
- 结构化结论回填:提取后的精简文本结论连同你的输入一同交由主力思考模型(如 Claude 3.7 / DeepSeek 等)编写代码;
- 收益:毫秒级响应、上下文 Token 消耗降低 70%~90%、推理成本趋近于零。
免费视觉模型获取教程(Google AI Studio 免费 1500 次/天、硅基流动 Qwen-VL、本地 Ollama):请直接查阅 视觉模型与委托配置指引。
3. 输出委托模型 (Output Delegation)
3.1 机制说明
输出委托旨在通过一个轻量且语言表达更通顺的模型,对原始推理模型的输出结论进行结构化重写与排版润色。
现状说明
在当前版本中,该功能主要用于实验性测试。对于大多数现代顶级编程模型(如 Claude 3.7 Sonnet、DeepSeek V3/R1),其原生表达与代码结构已经非常优秀,通常无需开启输出委托;若非特定需求,保持默认关闭即可。
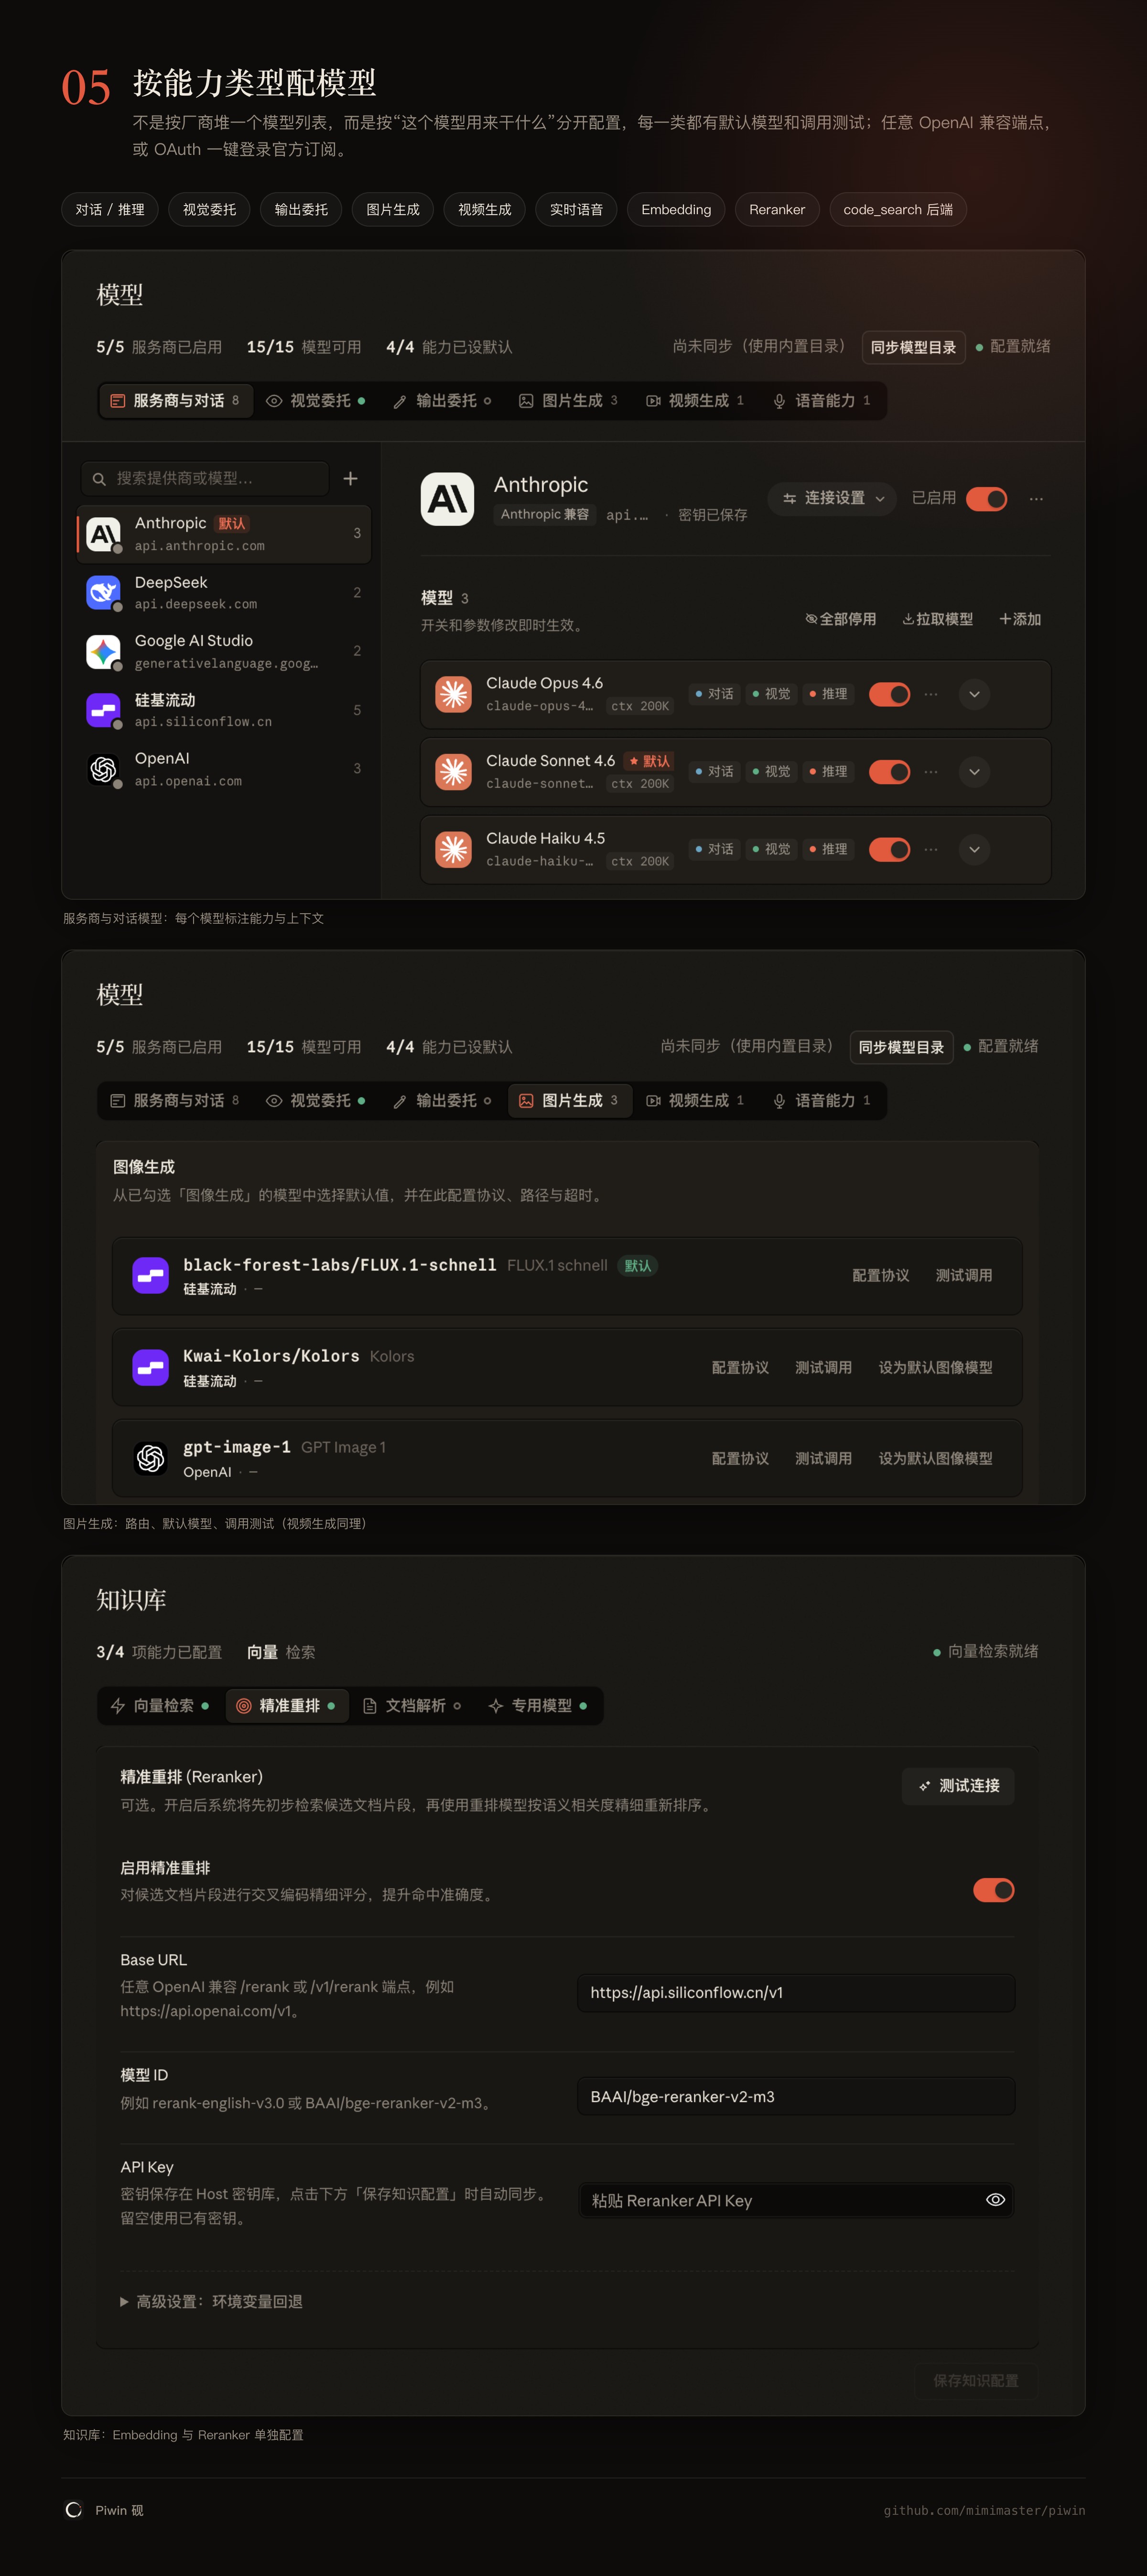
4. 图像生成模型 (Image Generation · image_gen)
Piwin 内置了原生的 image_gen 工具契约。当你在对话中要求智能体“生成一张配图”、“绘制一个应用图标”或“设计一张海报草图”时:
- 智能体会自动调用
image_gen工具; - 系统会使用你在图像生成模型中配置的默认模型进行出图;
- 生成的图像会自动安全保存在本地资产库(
~/.piwin/media/)并在客户端中原生渲染图片卡片,无需手动拼接 Markdown 图片语法。
支持模型类型:
- OpenAI DALL-E 3 (
dall-e-3); - xgrok Web 渠道:通过社区开源 xgrok 桥接免费 Grok 账号的 Imagine 生图端点,或 FLUX 系列;
- 硅基流动 / 智谱等兼容 OpenAI 图像格式的模型(如
black-forest-labs/FLUX.1-schnell、CogView等); - 自定义文生图 API 端点。
5. 视频生成模型 (Video Generation · video_gen)
与生图模型类似,Piwin 内置了 video_gen 动态短视频生成工具:
- 输入支持:支持根据纯文本描述(Text-to-Video)或参考图片路径(Image-to-Video)生成短视频片段;
- 配置方式:在视频生成模型栏目中填入支持视频生成的 API 端点、Key 与 Model ID:
- xGrok Videos (
xgrok-videos):如果你使用免费 Grok 账号配合社区xgrok,协议选择xGrok Videos(请求路径/videos/generations),填入如grok-imagine-video,即可零成本白嫖短视频生成能力; - OpenAI / 自定义视频端点:支持填写各类商用视频生成服务的端点与凭证;
- xGrok Videos (
- 呈现效果:视频生成完成后由前端原生渲染播放器组件,支持循环预览与本地下载。